Simple-2048-RL
從遊戲狀態到策略,練習理解強化學習。
從什麼問題開始
DQN 強化學習訓練 AI 玩 2048。環境建置、神經網路、訓練 pipeline 全部從頭刻。想驗證強化學習在策略遊戲上到底能走多遠。
做了哪些事
- 實作 2048 環境、神經網路與訓練流程,使用 Pygame 呈現棋盤。
- 以 log2 編碼、epsilon-greedy、MSE 與 Adam 理解訓練的各個環節。
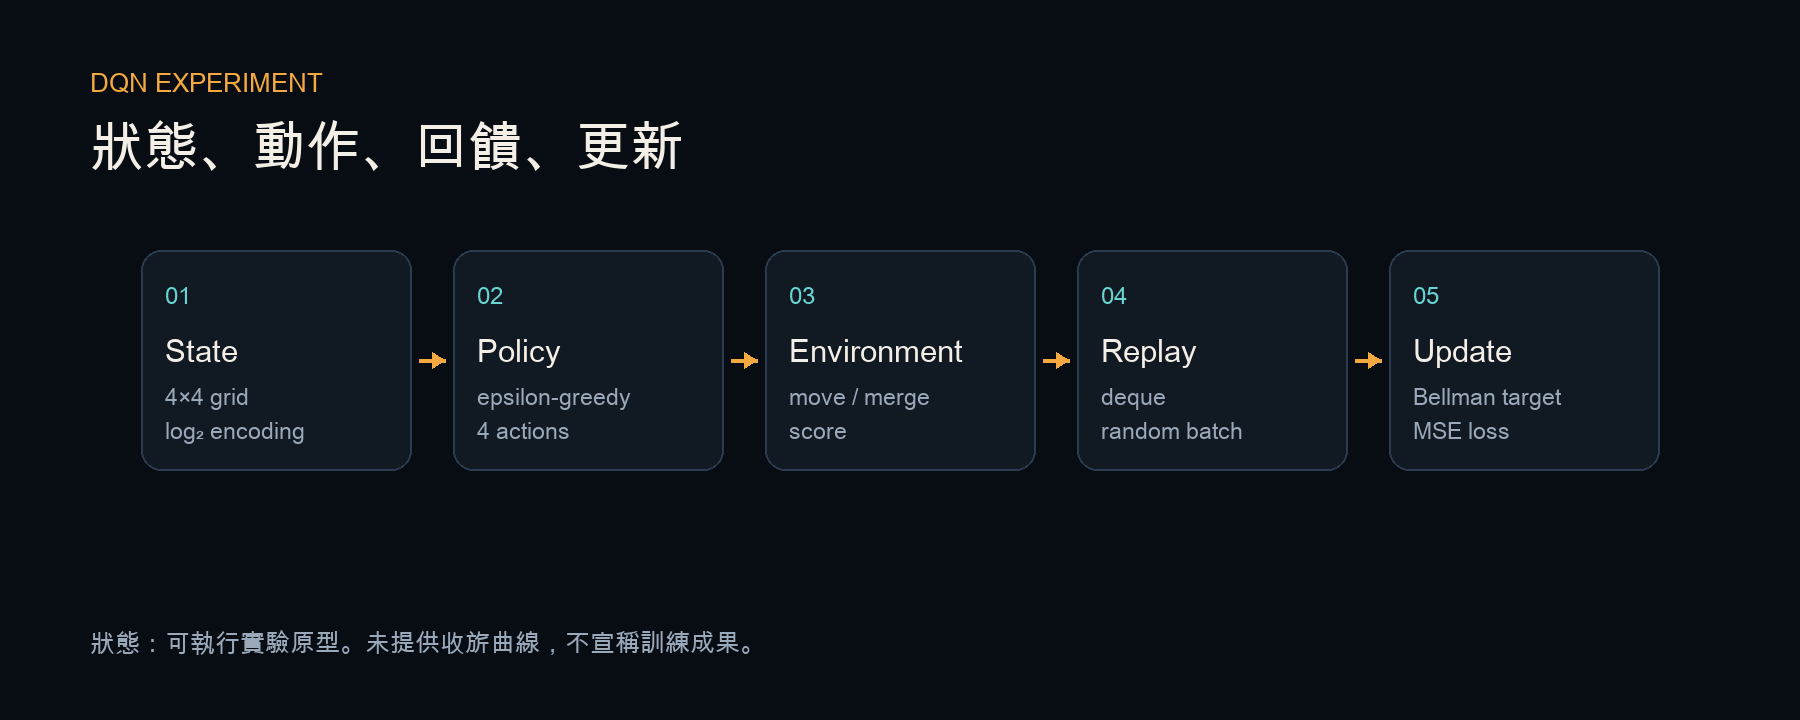
資料怎麼走
點開一站,看它做什麼,以及需要注意的地方。
-
0116 維狀態
將 2048 的 4 × 4 棋盤編碼,作為網路輸入。
- 產出
- 棋盤狀態向量
- 需要留意
- 狀態表示會影響模型看到的資訊;本專案使用 log2 編碼。
-
024 種動作
在上、下、左、右中選擇動作,以 epsilon-greedy 平衡探索與利用。
- 產出
- 下一個移動方向
- 需要留意
- 首頁的走一步只是規則示意,並未執行這個模型。
-
03獎勵回饋
執行動作後,由遊戲環境回傳下一個狀態與獎勵。
- 產出
- 狀態轉移與回饋
- 需要留意
- 單次得分或好看的棋盤,不能代替多次訓練評估。
-
04Replay buffer
保存經驗,供訓練時抽樣使用。
- 產出
- 可取樣的經驗資料
- 需要留意
- 需要配合訓練紀錄檢查,不能只從有經驗回放就推論模型已收斂。
-
05DQN 更新
用 MSE 與 Adam 更新神經網路,練習估計動作價值。
- 產出
- 更新後的網路參數
- 需要留意
- 目前沒有 target network 或 Double DQN,也尚未完成多個隨機種子的基準比較。